تحسين محركات البحث الفنية لبحث الذكاء الاصطناعي: 4 أساسيات مهمة
على الرغم مما قد يخبرك به موجز LinkedIn الخاص بك، فإن الاسترجاع باستخدام الذكاء الاصطناعي ليس نظامًا جديدًا. إنه اختبار إجهاد لأساسيات تحسين محركات البحث الفنية التي تعد بالفعل أفضل الممارسات.
عادةً ما تتأثر مواقع الويب التي تعاني من رؤية الذكاء الاصطناعي بنفس المشكلات الفنية التي أدت إلى انخفاض تصنيفات البحث لفترة طويلة. هناك بعض مربعات الاختيار الإضافية التي يجب مراجعتها، ولكن ليس هناك سر كبير للتأكد من أن موقع الويب الخاص بك سليم من الناحية الفنية لرؤية الذكاء الاصطناعي.
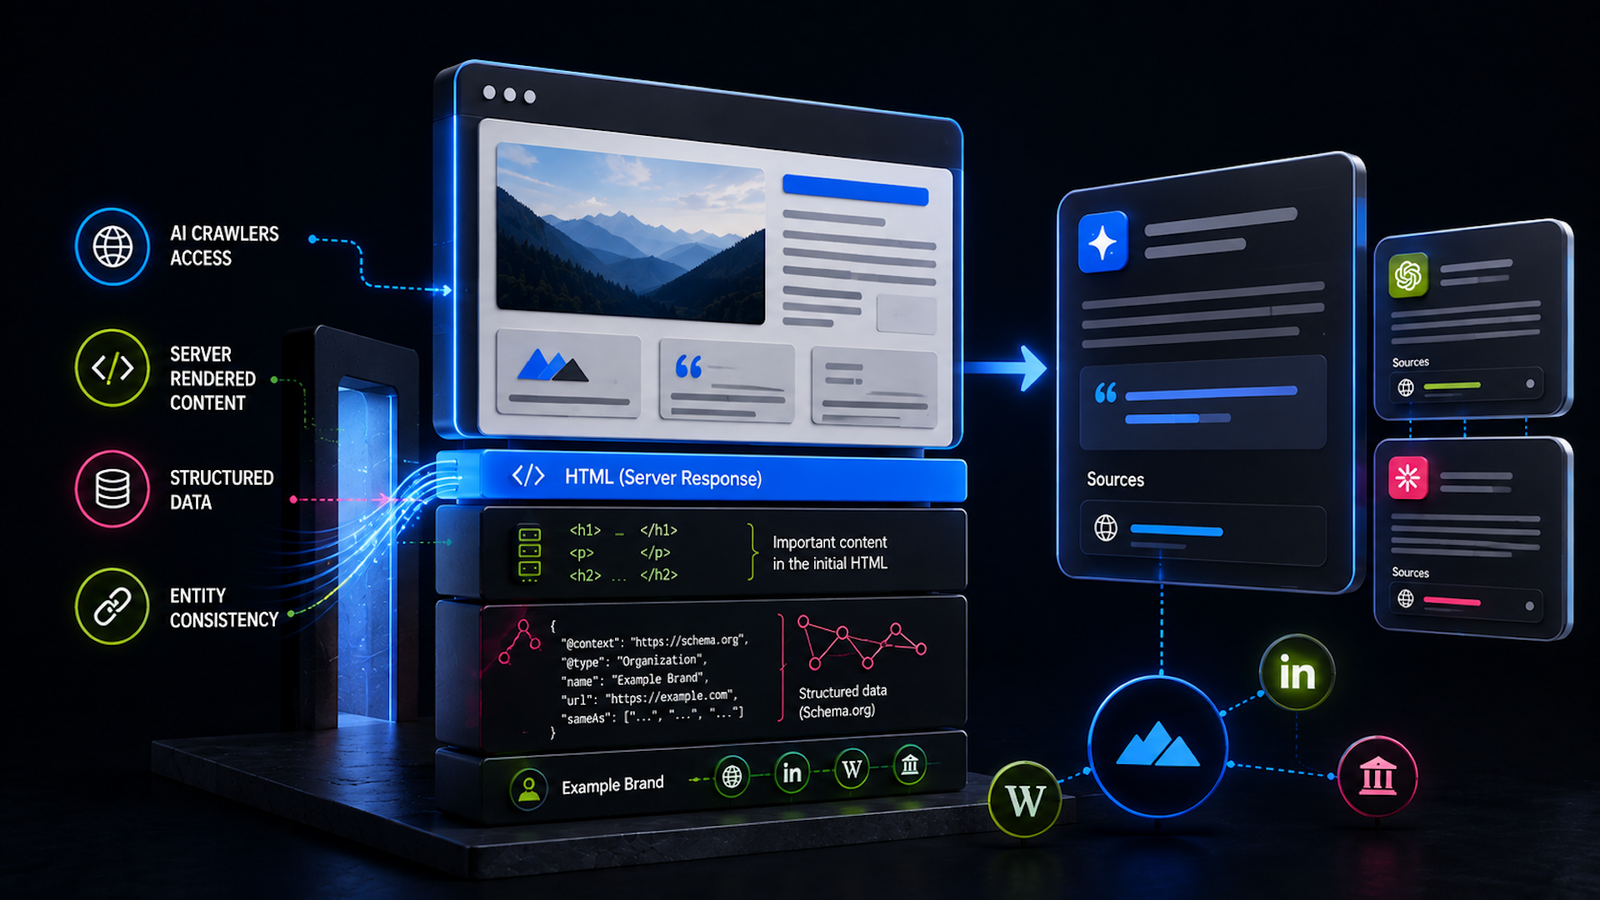
فيما يلي أربعة عناصر فنية يجب مراجعتها للتأكد من قدرة أنظمة الذكاء الاصطناعي على الزحف إلى موقع الويب الخاص بك وفهمه والاستشهاد به.
1. إمكانية الزحف والوصول إلى الروبوتات
أدى ظهور مساعدي الذكاء الاصطناعي إلى توسيع النظام البيئي للزاحف إلى ما هو أبعد من Googlebot وBingbot. تقوم OpenAI وAnthropic وPerplexity الآن بتشغيل روبوتات متعددة – بعضها للتدريب على النماذج، وبعضها للاسترجاع، وبعضها للاستعلامات التي يبدأها المستخدم – ولكل منها سلوكيات وتأثيرات مختلفة على مالكي مواقع الويب.
ومع ذلك، لا تزال العديد من المواقع تعتمد على ملفات robots.txt التي تم تحديثها آخر مرة منذ سنوات، مما أدى عن غير قصد إلى حظر الروبوتات التي يريدون الآن الحصول على الرؤية من خلالها.
يعد ملف robots.txt بمثابة حارس البوابة عندما يتعلق الأمر بإمكانية الزحف إلى الذكاء الاصطناعي، وفقًا لـ Cloudflare Radar.
تعمق أكثر: الزحف للبحث عن الذكاء الاصطناعي: تحقيق التوازن بين الوصول والتحكم والرؤية
المشهد الزاحف الحديث للذكاء الاصطناعي
لا تعتمد أنظمة الذكاء الاصطناعي على روبوت واحد. يستخدمون عائلات برامج الزحف لأغراض مختلفة. على سبيل المثال، يحتوي Anthropic على ClaudeBot وClaude-SearchBot وClaude-User. يتم استخدام ClaudeBot للتدريب، في حين يقوم Claude-SearchBot وClaude-User بالتعامل مع الاسترجاع والتصفح.
تتصرف بعض روبوتات الاسترجاع المستندة إلى الذكاء الاصطناعي بشكل يشبه المتصفحات عند الطلب أكثر من برامج زحف البحث التقليدية. تقوم روبوتات الاسترجاع بجلب الصفحات في الوقت الفعلي عندما يطرح المستخدم سؤالاً. تزحف روبوتات التدريب على نطاق واسع لبناء المعرفة النموذجية. ولذلك، يجب التعامل مع كل منها بشكل مناسب.
يعتمد الوصول الذي تسمح به لكل روبوت على قرار العمل. بالنسبة لصناعات مثل الأخبار والناشرين، يعد المحتوى شريان الحياة، وغالبًا ما يختارون حظر الذكاء الاصطناعي.
ويكمن قلقهم في أن أنظمة الذكاء الاصطناعي قد تستخدم محتواها دون إعادة الزوار إلى المصدر الأصلي. قد تقوم أيضًا المنظمات في القطاعات الخاضعة للتنظيم، بما في ذلك الخدمات القانونية، بحظر برامج زحف الذكاء الاصطناعي بسبب مخاوف تتعلق بالامتثال.
تقوم مجموعة ثالثة بحظر برامج زحف الذكاء الاصطناعي عن غير قصد. نظرًا لأن العديد من المواقع تقوم بتشغيل ملفات robots.txt المكتوبة منذ سنوات، فليس من غير المألوف العثور على قواعد تحظر برامج الاسترداد عن غير قصد أثناء محاولة حظر برامج الزحف التدريبية، أو العكس.
والنتيجة غير مرئية: لا تستطيع أنظمة الذكاء الاصطناعي جلب صفحاتك أثناء استعلامات المستخدم، ولن ترى انخفاضًا في التصنيف على غرار محرك البحث التقليدي – ستغيب ببساطة عن الإجابات المستندة إلى الذكاء الاصطناعي.
الإصلاح: تأكد من انعكاس نيتك في تكوين ملف robots.txt الخاص بك. إذا كنت تريد أن تكون قابلة للاكتشاف بواسطة وكلاء الاسترجاع الذين يعملون بالذكاء الاصطناعي، فتعامل معهم باعتبارهم برامج زحف من الدرجة الأولى في ملف robots.txt الخاص بك. إذا كنت تريد حظر برامج الزحف التدريبية، فافعل ذلك بشكل صريح وتأكد من أنك لا تلتقط عملاء الاسترداد بنفس القاعدة.
إن السماح للزاحف عبر ملف robots.txt هو الخطوة الأولى فقط. ويجب أن يكون قادرًا أيضًا على الوصول إلى المحتوى المهم للصفحة.
امتلك المحادثة قبل منافسيك.
تعرف على مكان ظهور علامتك التجارية، وأين لا تظهر، وكيفية الحصول على مزيد من الرؤية عبر البحث، والذكاء الاصطناعي، والمحلية، والاجتماعية، وكل قناة مهمة.
ابدأ تجربتك المجانية
2. عرض جافا سكريبت: القاتل الصامت
يعد عرض JavaScript هو الخطر الفني الوحيد الذي يتم التغاضي عنه فيما يتعلق برؤية الذكاء الاصطناعي. لا تعرض أي من برامج زحف الذكاء الاصطناعي الرئيسية JavaScript. وهذا يعني أن أي محتوى يتم إدخاله في المتصفح – مخطط أو نص أو تفاصيل المنتج أو بيانات التعريف المهمة – يمكن أن يكون غير مرئي لأنظمة الذكاء الاصطناعي حتى عندما يقوم Google ومحركات البحث الأخرى بفهرسة الصفحة بشكل مثالي.
لماذا هذا؟
غالبًا ما تعرض التطبيقات الحديثة ذات الصفحة الواحدة (SPA) المحتوى الأساسي من جانب العميل. إذا كانت استجابة الخادم تحتوي على الصدفة فقط وقام جافا سكريبت بملء المحتوى لاحقًا، فإن زاحف الذكاء الاصطناعي الذي لا يقوم بتشغيل JS سيرى الصدفة فقط. بالإضافة إلى ذلك، تتجنب بعض برامج الزحف عمدًا تنفيذ JS لتقليل التكلفة وزمن الوصول والتعقيد.
حتى عندما يتمكن الزاحف من تنفيذ JavaScript، فإن حدود المعدل والمهلات والاختلافات بين المتصفحات بدون رأس يمكن أن تنتج عروضًا غير مكتملة. وبالتالي فإن العرض من جانب العميل ليس طريقة تسليم يمكن الاعتماد عليها للمحتوى المهم.
لنأخذ مثالا. خذ بعين الاعتبار React SPA الذي يعمل بشكل جيد في Google نظرًا لأنه يتم حقن محتواه ومخططه من جانب العميل، ولكنه يظل غير مرئي لأنظمة استرجاع الذكاء الاصطناعي. ترى برامج زحف الذكاء الاصطناعي صفحة شبه فارغة بسبب التكنولوجيا المستخدمة.
الإصلاح: استخدم العرض من جانب الخادم (SSR)، أو إنشاء الموقع الثابت (SSG)، أو العرض المختلط للمحتوى المهم. تأكد من أن استجابة HTML تحتوي على النص الأساسي والعناوين والبيانات المنظمة. الرهان الأكثر أمانًا هو الاستمرار في استخدام لغة HTML المجربة والحقيقية للمحتوى المهم.
بمجرد أن يصبح المحتوى متاحًا، فإن التحدي التالي هو جعل معناه واضحًا.
تعمق أكثر: 5 دروس JavaScript SEO من أفضل مواقع التجارة الإلكترونية
احصل على النشرة الإخبارية التي يعتمد عليها مسوقو البحث.
انظر الشروط.
3. البيانات المنظمة والوضوح
مع نمو أنظمة استرجاع الذكاء الاصطناعي، فإنها تعتمد بشكل كبير على الإشارات المنظمة المضمنة في HTML. نظرًا لأن العديد من برامج زحف الذكاء الاصطناعي لا تقوم بتنفيذ JavaScript، فإن ترميز المخطط الذي يتم تسليمه من جانب الخادم هو الطريقة الموثوقة لضمان قدرة نظام الذكاء الاصطناعي على فهم محتوى صفحتك. بمعنى آخر، تضيف البيانات المنظمة معنى واضحًا إلى المعلومات الموجودة في HTML الخام.
البيانات المنظمة تعطي أنظمة الذكاء الاصطناعي معنى واضحا
تخبر البيانات المنظمة أنظمة الذكاء الاصطناعي عن هوية الكيان بالضبط، وكيفية ارتباطه بالكيانات الأخرى، وما يهم. عندما يقوم GPTBot أو ClaudeBot أو PerplexityBot بجلب صفحة ما، فقد يشاهدون فقط HTML الأولي.
إذا تم إدخال مخططك من جانب العميل – عبر React أو Vue أو أي إطار عمل SPA – فلن يراه الزاحف أبدًا، مما يعني عدم التعرف على الكيان أو استخراج الحقائق أو تضمينه في الإجابات التي ينشئها الذكاء الاصطناعي.
يمكن للبيانات المنظمة تحسين الدقة الواقعية
تعتمد أنظمة الذكاء الاصطناعي على إشارات واضحة يمكن قراءتها آليًا لتجنب سوء التفسير. يوفر ترميز Schema.org الأسماء الأساسية والأسعار والتواريخ والمؤلفين وسمات المنتج والعلاقات. وهذا يقلل من الغموض ويساعد أنظمة الذكاء الاصطناعي على اقتباس المحتوى الخاص بك أو تلخيصه بشكل صحيح.
قم بتضمين البيانات المنظمة في استجابة HTML الأولية
يمكن أن يضمن SSR وSSG وجود المخطط في استجابة HTML الأولية، مما يجعله في متناول برامج الزحف التي لا تنفذ JavaScript. القاعدة بسيطة: لا تعتمد أبدًا على JavaScript لتقديم المعلومات التي تريد أن تفهمها أنظمة الذكاء الاصطناعي.
يمكن للبيانات المنظمة أن تعزز رؤية بحث الذكاء الاصطناعي
نظرًا لأن مساعدي الذكاء الاصطناعي أصبحوا على نحو متزايد نقطة الاتصال الأولى لاسترجاع المعلومات، فإن المواقع التي توفر بيانات منظمة واضحة ومقدمة من الخادم ستكون في وضع أفضل لإدراجها في الإجابات التي ينشئها الذكاء الاصطناعي. سوف تتلاشى تلك التي تعتمد على الحقن من جانب العميل من رؤية الذكاء الاصطناعي حتى لو كان أداؤها جيدًا في البحث التقليدي.
الإصلاح: قم بمراجعة موقع الويب الخاص بك للتأكد من أن رمز ترميز المخطط قد تم عرضه من جانب الخادم ومرئيًا في استجابة HTML الأولية. تأكد من إمكانية الوصول إلى البيانات المنظمة المهمة دون تنفيذ JavaScript. تحقق من صحة التعليمات البرمجية الخاصة بك عن طريق جلب الصفحات كوكيل مستخدم لزاحف الذكاء الاصطناعي للتأكيد.
الوضوح على مستوى الصفحة ليس سوى جزء من المعادلة. ويجب على أنظمة الذكاء الاصطناعي أيضًا ربط هذه الحقائق بكيان علامة تجارية متسقة.
4. اتساق الكيان مهم
عندما يتم تمثيل العلامة التجارية باستمرار ككيان واحد، فإن أنظمة الذكاء الاصطناعي لديها أساس أكثر وضوحًا لتحديدها ووصفها بدقة. لا يقتصر هذا على الرسم البياني المعرفي لـ Google فقط. تحتفظ كل من Anthropic وOpenAI وMicrosoft بطبقات كيانات داخلية تعتمد على هويات علامات تجارية مستقرة لا لبس فيها.
يعكس أحد أجزاء التحدي مشكلة اتساق NAP القديمة من تحسين محركات البحث المحلية، ولكن على نطاق العلامة التجارية. يجب عليك تقليل الاختلافات غير الضرورية في الأسماء وجعل العلاقات التي لا يمكن تجنبها واضحة.
يمكن لأسماء العلامات التجارية غير المتسقة عبر موقع الويب الخاص بك والمخطط والأدلة وملفات التعريف الاجتماعية والقوائم الخارجية أن تؤدي إلى تجزئة الكيان. عندما تكون الاختلافات مثل “Acme” و”Acme Co.” و”Acme Inc.” لا يمكن تجنبها، وربطها من خلال بيانات منظمة متسقة وملفات تعريف خارجية موثوقة.
تعمل بصمة الكيان الموحد على تعزيز تكرار الاستشهادات، وتحسين دقة الإجابات، وتضمن التعرف على علامتك التجارية كمصدر واحد موثوق به عبر أنظمة الذكاء الاصطناعي الحديثة.
الإصلاح: قم بمراجعة مراجع العلامة التجارية وتوحيد التهجئة وعلامات الترقيم والأحرف الكبيرة واستخدام الاسم القانوني حيثما أمكن ذلك. بالإضافة إلى ذلك، عزز تلك الهوية بروابط مماثلة للعقد الخارجية الأساسية مثل Wikidata وLinkedIn وCrunchbase. تعمل هذه بمثابة مرتكزات أساسية، مما يساعد أنظمة الذكاء الاصطناعي على دمج الاختلافات في كيان واحد موثوق.
يجب اعتبار أي من هذه الإصلاحات كاملة حتى يتم اختبار الإخراج النهائي.
تحقق، اختبر، كرر
لا تكون الإصلاحات الفنية ذات قيمة إلا إذا تمكنت برامج الزحف من الوصول إلى النتيجة النهائية وتفسيرها. افحص الصفحات المهمة للتأكد من وجود النسخ المهمة والعناوين والروابط الداخلية والبيانات المنظمة قبل تشغيل JavaScript.
اختبار الوصول عبر ملف robots.txt، وتوجيهات الروبوتات التعريفية، ورموز الحالة، وعمليات إعادة التوجيه، وقواعد جدار الحماية. يمكن أن تساعد سجلات الخادم في تأكيد ما إذا كانت برامج زحف الذكاء الاصطناعي تصل إلى صفحاتك وتتلقى استجابات ناجحة. التحقق من صحة البيانات المنظمة باستخدام أداة التحقق من صحة ترميز المخطط واختبار النتائج الغنية من Google.
وأخيرًا، تتبع رؤية الذكاء الاصطناعي بشكل منفصل عن التصنيفات التقليدية. استخدم مجموعة متسقة من المطالبات لمراقبة إشارات العلامة التجارية، والاستشهادات، وصفحات المصدر، والدقة الفعلية عبر منصات الذكاء الاصطناعي ذات الصلة. ستختلف الاستجابات الفردية، لذا ركز على الأنماط بمرور الوقت بدلاً من عمليات التفتيش العشوائية المعزولة.
تحسين محركات البحث الفنية هو أساس رؤية الذكاء الاصطناعي
قد تبدو رؤية الذكاء الاصطناعي بمثابة نظام جديد، لكن المتطلبات التقنية مألوفة. تحتاج محركات البحث وأنظمة استرجاع الذكاء الاصطناعي إلى صفحات يمكن الوصول إليها ومعلومات واضحة وكيانات متسقة وإشارات يمكن قراءتها آليًا. الفرق هو أن العديد من برامج زحف الذكاء الاصطناعي تعمل بقدرات عرض أقل وتسامح أقل مع الغموض.
الهدف ليس تحسين كل زاحف على حدة أو مطاردة كل منصة جديدة للذكاء الاصطناعي. إنه إنشاء موقع ويب مرن تقنيًا يعرض أهم معلوماته بوضوح. تسهل المواقع التي تقوم بذلك على محركات البحث وأنظمة الذكاء الاصطناعي الزحف إلى محتواها وفهمه والتحقق منه والاستشهاد به.
الوجبات السريعة الرئيسية
تأكد من أن ملف robots.txt وجدار الحماية وعناصر التحكم في الوصول تعكس سياستك الفعلية لتدريب برامج الزحف والاسترجاع.
لا تعتمد على JavaScript لتقديم محتوى مهم أو بيانات منظمة.
استخدم ترميز المخطط ذي الصلة وأدرجه في استجابة الخادم الأولية.
حافظ على كيان متسق للعلامة التجارية عبر موقع الويب الخاص بك والبيانات المنظمة والملفات الشخصية والمصادر الخارجية الموثوقة.
تحقق من التنفيذ من خلال فحص HTML الأولي، واختبار الزاحف، والتحقق من صحة المخطط، وتتبع اقتباسات الذكاء الاصطناعي القابلة للتكرار.
لقد أدى بحث الذكاء الاصطناعي إلى زيادة المخاطر، لكنه لم يعيد كتابة قواعد اللعبة التقنية. ستكون مواقع الويب التي تطبق الأساسيات بشكل صحيح في وضع أفضل لأداء البحث التقليدي والعدد المتزايد من تجارب الاكتشاف المعتمدة على الذكاء الاصطناعي.

إرسال التعليق